In het kort
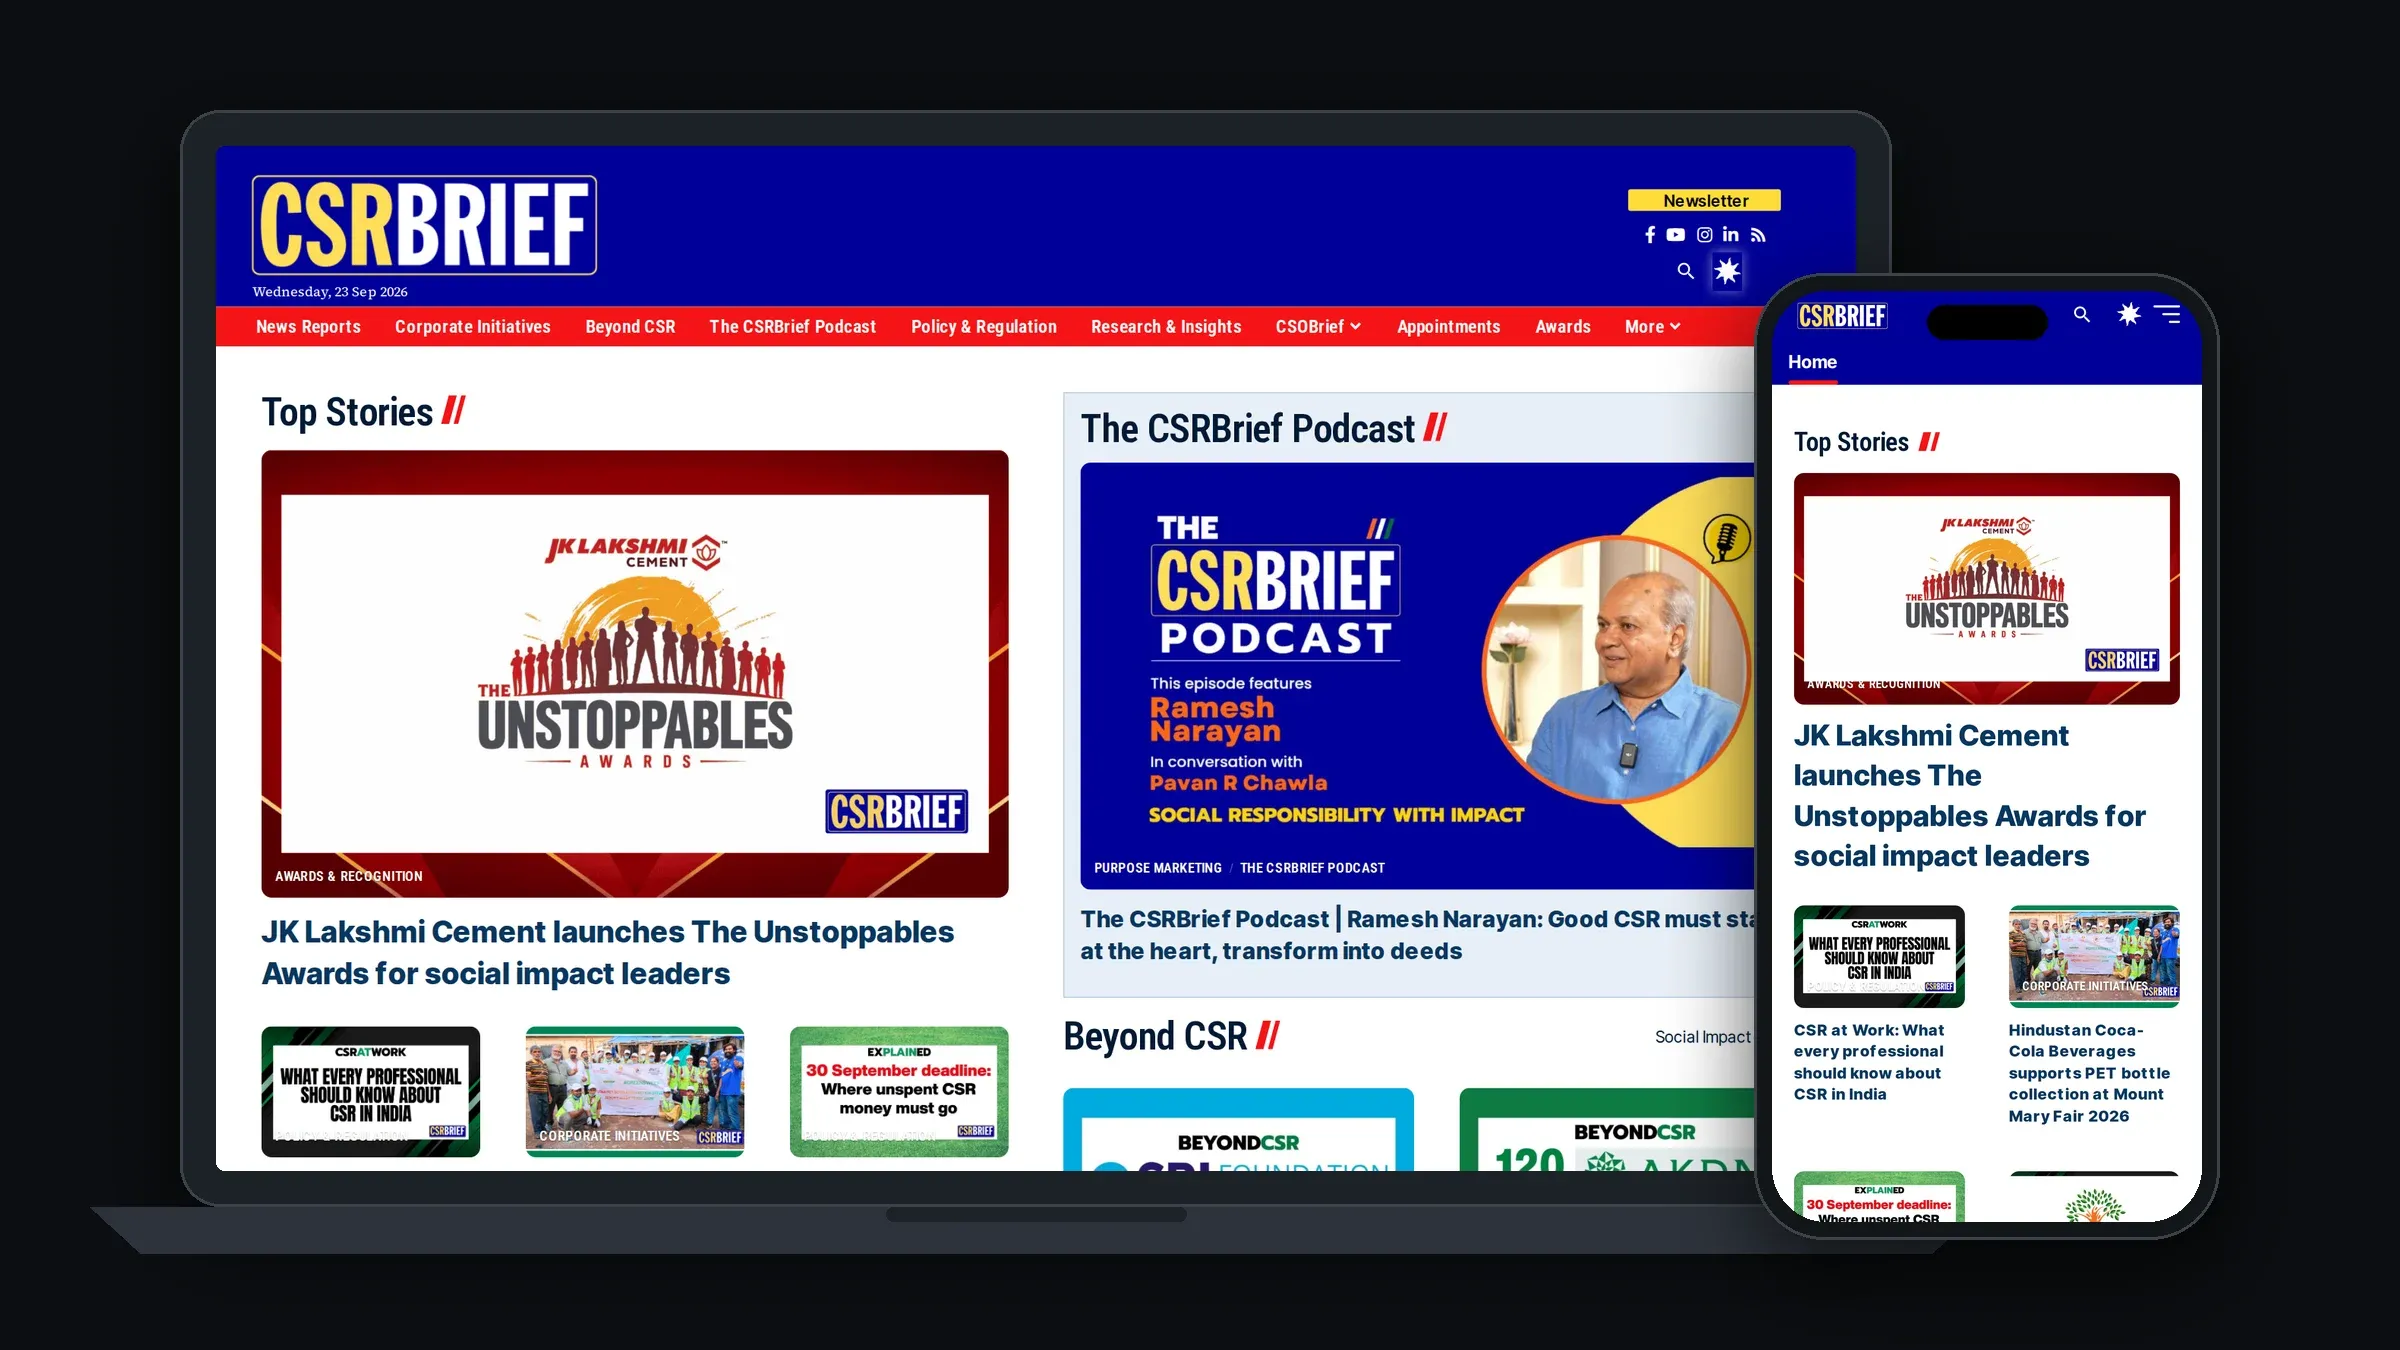
CSRBrief is een Indiaas nieuwsplatform over maatschappelijk verantwoord ondernemen (CSR), ESG en duurzaamheid. De hoofdredacteur wilde dat de site gevonden en geciteerd wordt, door Google en door AI-systemen zoals ChatGPT en Perplexity. Ik bouwde een nieuwe homepage naar zijn ontwerp, ruimde dubbele en foute SEO-signalen op, breidde het schema uit en haalde ongeveer 900 dunne tagpagina’s uit de sitemap. Alles staat live en is gecontroleerd op de live site; het effect op de indexering meet ik nog.
Feiten in één oogopslag
| Klant | CSRBrief, uitgegeven door Responsible Media Private Limited |
|---|---|
| Sector | Nieuws en media over CSR, ESG en duurzaamheid (India) |
| Periode | Augustus 2026 tot nu |
| Disciplines | Webdevelopment, SEO, GEO, Strategie |
| Techniek | WordPress, Foxiz, Elementor, All in One SEO Pro, Cloudflare, Search Console, GA4 |
| Status | Live, doorlopend |
Over de klant
CSRBrief brengt dagelijks nieuws over bedrijfsinitiatieven, beleid, onderzoek en opinie, plus een eigen podcast. De site is jong en heeft een ouder zustermedium bij dezelfde uitgever. De redactie publiceert meerdere artikelen per dag, dus alles wat ik bouw moet zichzelf vullen zonder handwerk.
De vraag
De hoofdredacteur wilde een nieuwe homepage volgens zijn eigen ontwerp, en een site die technisch klaar is om gevonden en geciteerd te worden. Zijn uitgangspunt was duidelijk: gevonden en geciteerd worden weegt zwaarder dan content afschermen. Dat werd de leidraad bij elke keuze over crawlers, robots.txt en llms.txt (een bestand dat AI-systemen een overzicht van de site geeft).
De uitgangssituatie
Ik begon met een nulmeting (een vastgelegde beginstand) van zes kernpagina’s: statuscode, canonical, schema, titel en laadtijd. Wat ik vond:
- Het thema had een eigen SEO-module die naast de SEO-plugin draaide. Daardoor stond de meta description twee keer op elke pagina, één keer met demotekst.
- Auteurs-, tag- en datumarchieven toonden nul artikelen. Ze verwezen naar een sjabloon dat niet meer bestond.
- De sitemap bood ongeveer 1.100 adressen aan, waarvan ruwweg 85 procent tagpagina’s met één of twee artikelen die op noindex (niet opnemen in Google) stonden.
Wat ik deed
De homepage
Ik bouwde de homepage met een script in plaats van met de hand. Gaat er iets mis, dan bouw ik hem opnieuw op in plaats van veertig blokken terug te zetten. Elk blok vult zichzelf vanuit een categorie of tag, dus de redactie hoeft niets bij te houden. Ik volgde het ontwerp van de klant tot op de kopgroottes en kleuren, en zorgde dat elk blok ook in de donkere modus van het thema leesbaar is.
Techniek en indexering
Ik zette de dubbele SEO-functies van het thema uit. Ik herstelde de lege archieven en zette dunne archieven (minder dan drie artikelen) automatisch op noindex. Tags haalde ik uit de sitemap en uit llms.txt. Bewust niet gedaan: categorieën verwijderen. Dat had redirects gevraagd, en de redactie vult ze toch.
Schema voor zoekmachines en AI
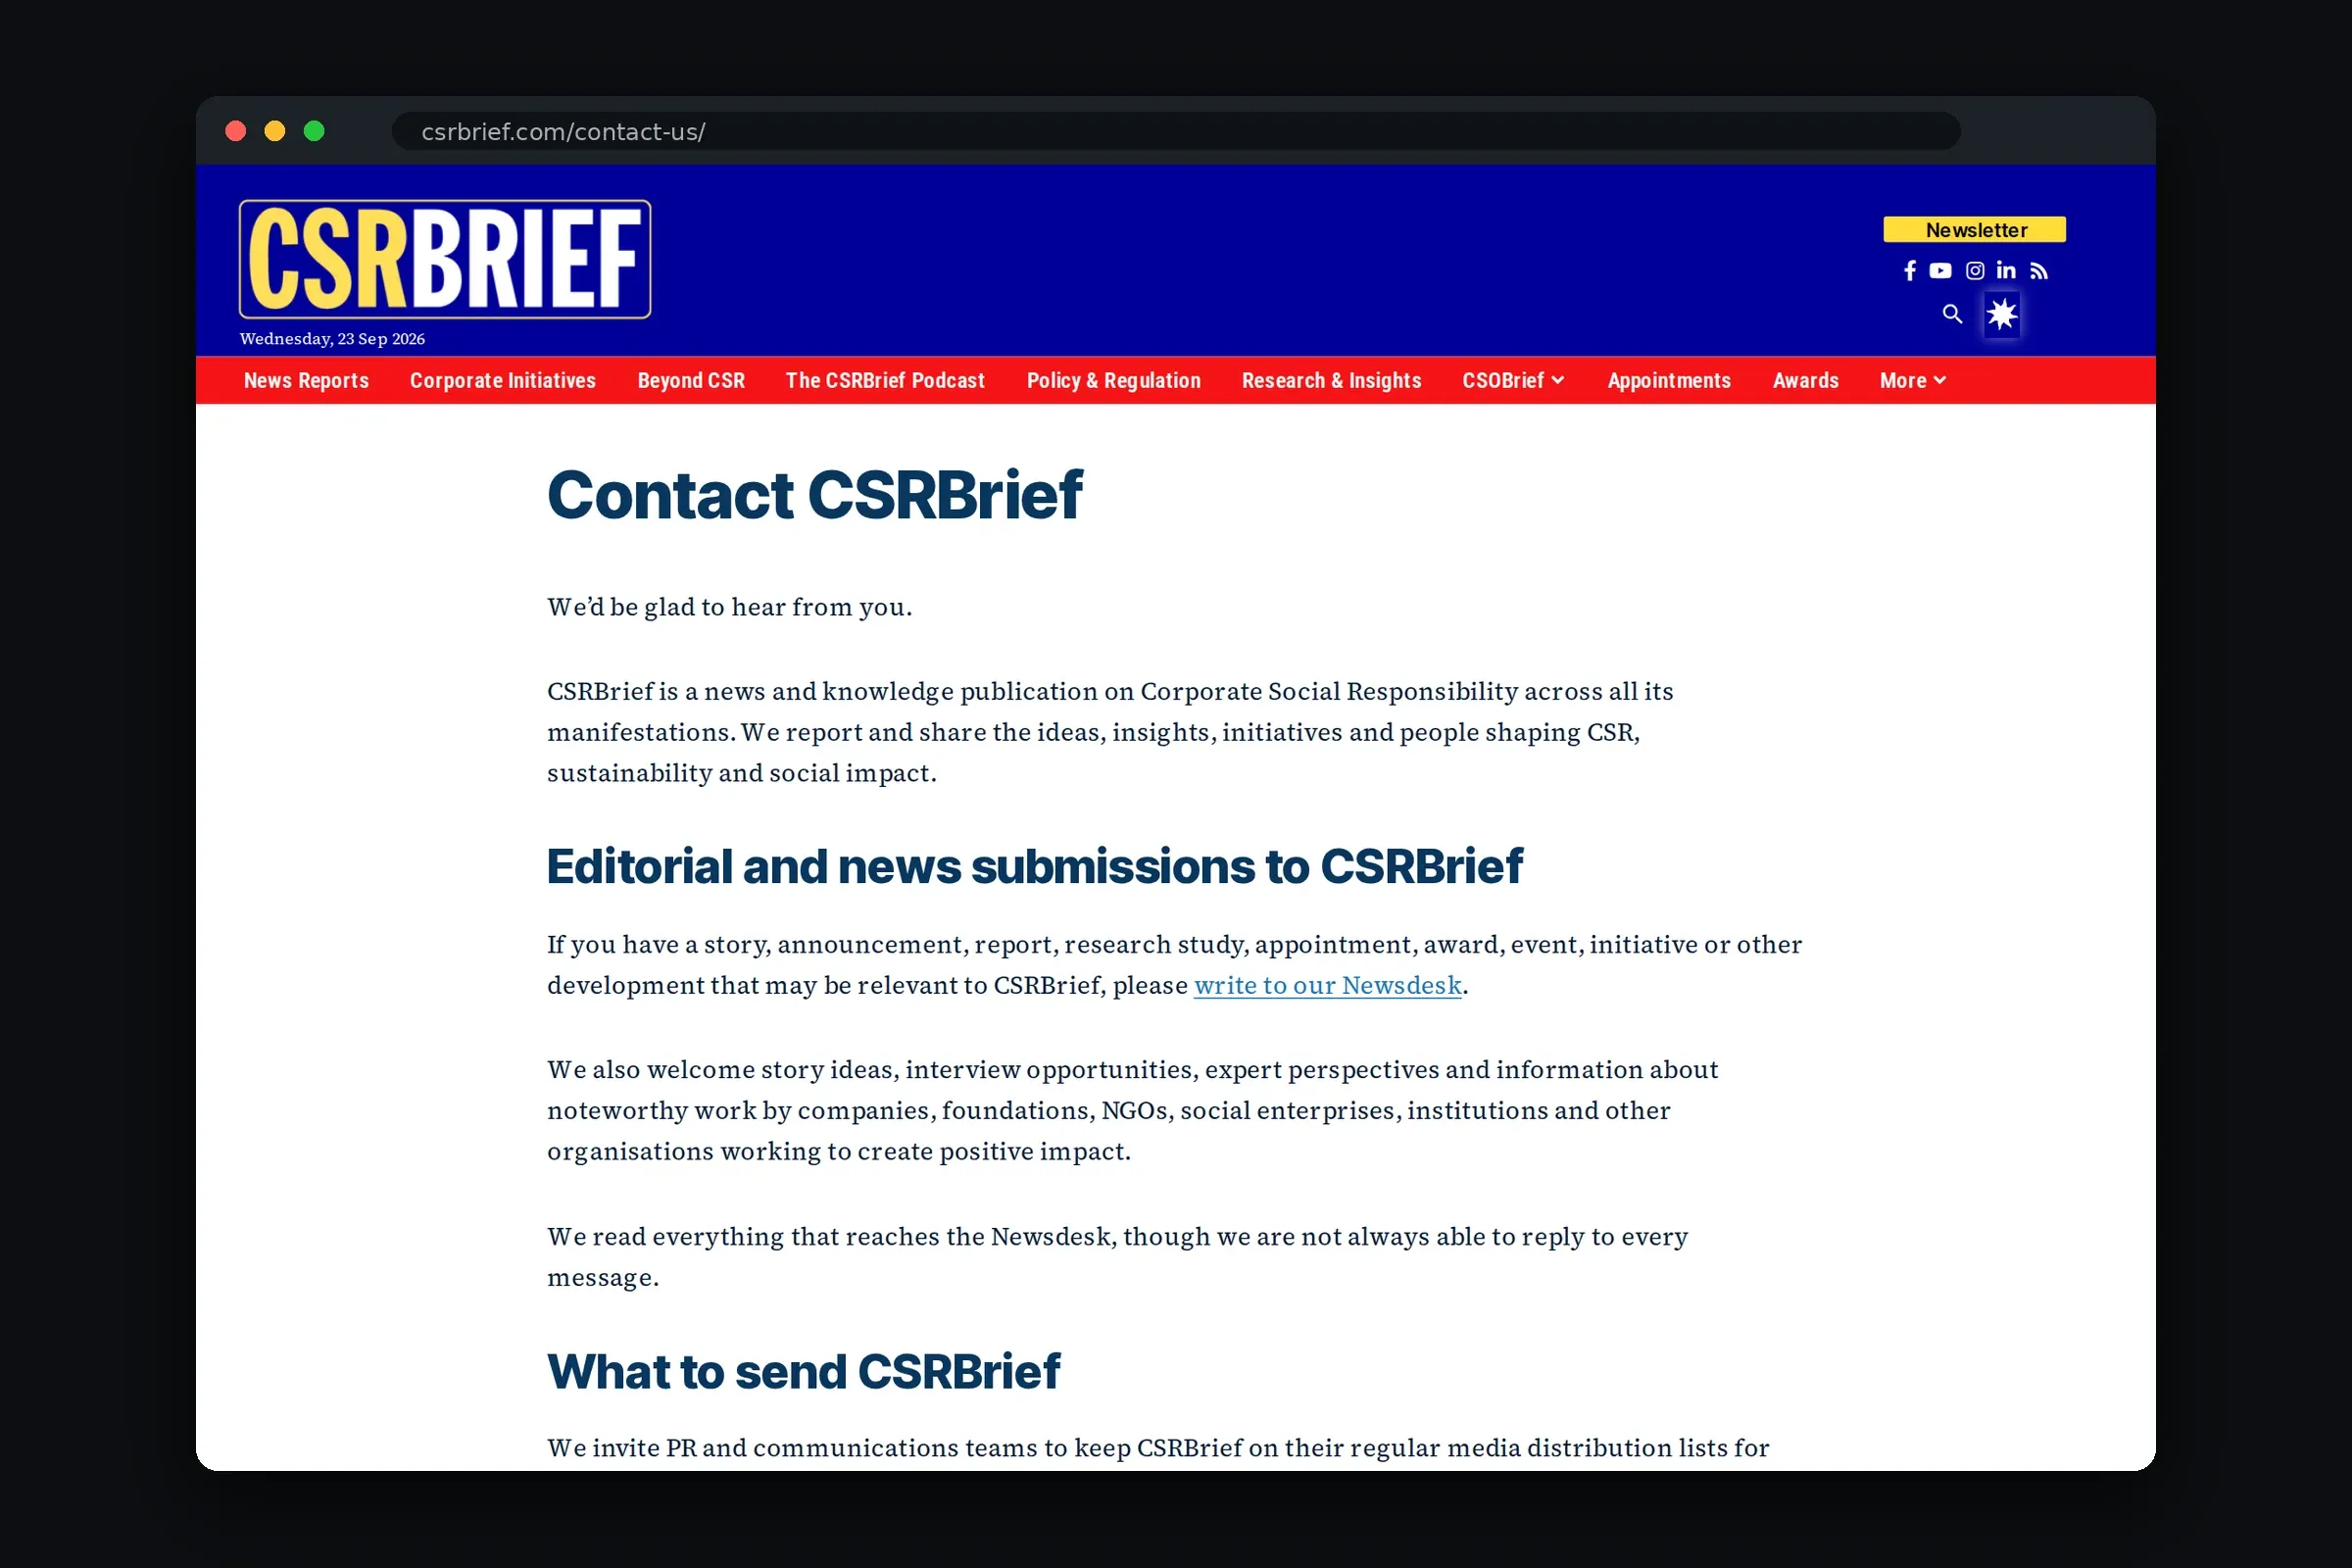
Ik breidde het bestaande schema uit, in plaats van er een tweede blok naast te zetten. Twee blokken over dezelfde pagina laten Google kiezen. Nieuw zijn onder meer: podcastschema dat elke nieuwe aflevering vanzelf oppakt, volledige auteursgegevens voor alle auteurs, een ContactPage met de redactie en de commerciële afdeling apart, en het type Article in plaats van NewsArticle voor de tijdloze reeks Beyond CSR.
Meten en e-mail
Ik plaatste GA4 één keer, zonder extra plugin. De klant paste zelf de DNS aan voor e-mailauthenticatie (bewijs dat mail echt van het domein komt). Ik controleerde elke stap in de publieke DNS.
Hoe ik het controleerde
Ik meet altijd op de live pagina, uitgelogd, na het legen van de sitecache en Cloudflare. In de editor kan iets opgeslagen lijken terwijl dat niet zo is.
- Bij de livegang van de homepage vergeleek ik titel en meta description met de nulmeting. Direct daarna stond de paginanaam als titel in de broncode. Met het oog zie je dat niet. Hersteld en daarna woord voor woord gelijk aan de nulmeting.
- De homepage, een artikel en de auteurspagina heb ik gemeten op 390, 940 en 1440 pixels breed: geen horizontaal schuiven.
- In de donkere modus mat ik het contrast per blok. Eerst stonden 25 plekken op 1,1 op 1, dus onleesbaar. Na de reparatie: nul plekken onder 3 op 1.
- Na elke schemawijziging controleerde ik ook pagina’s die niet mochten veranderen. Na de Article-regel voor Beyond CSR bleven drie gewone nieuwsberichten NewsArticle.
- Een eerste poging om de sitemap via code op te schonen haalde ook de artikelen eruit, van 143 naar 1. Dat zag ik direct in de telling. Ik heb het teruggedraaid en de instelling in de SEO-plugin gebruikt.
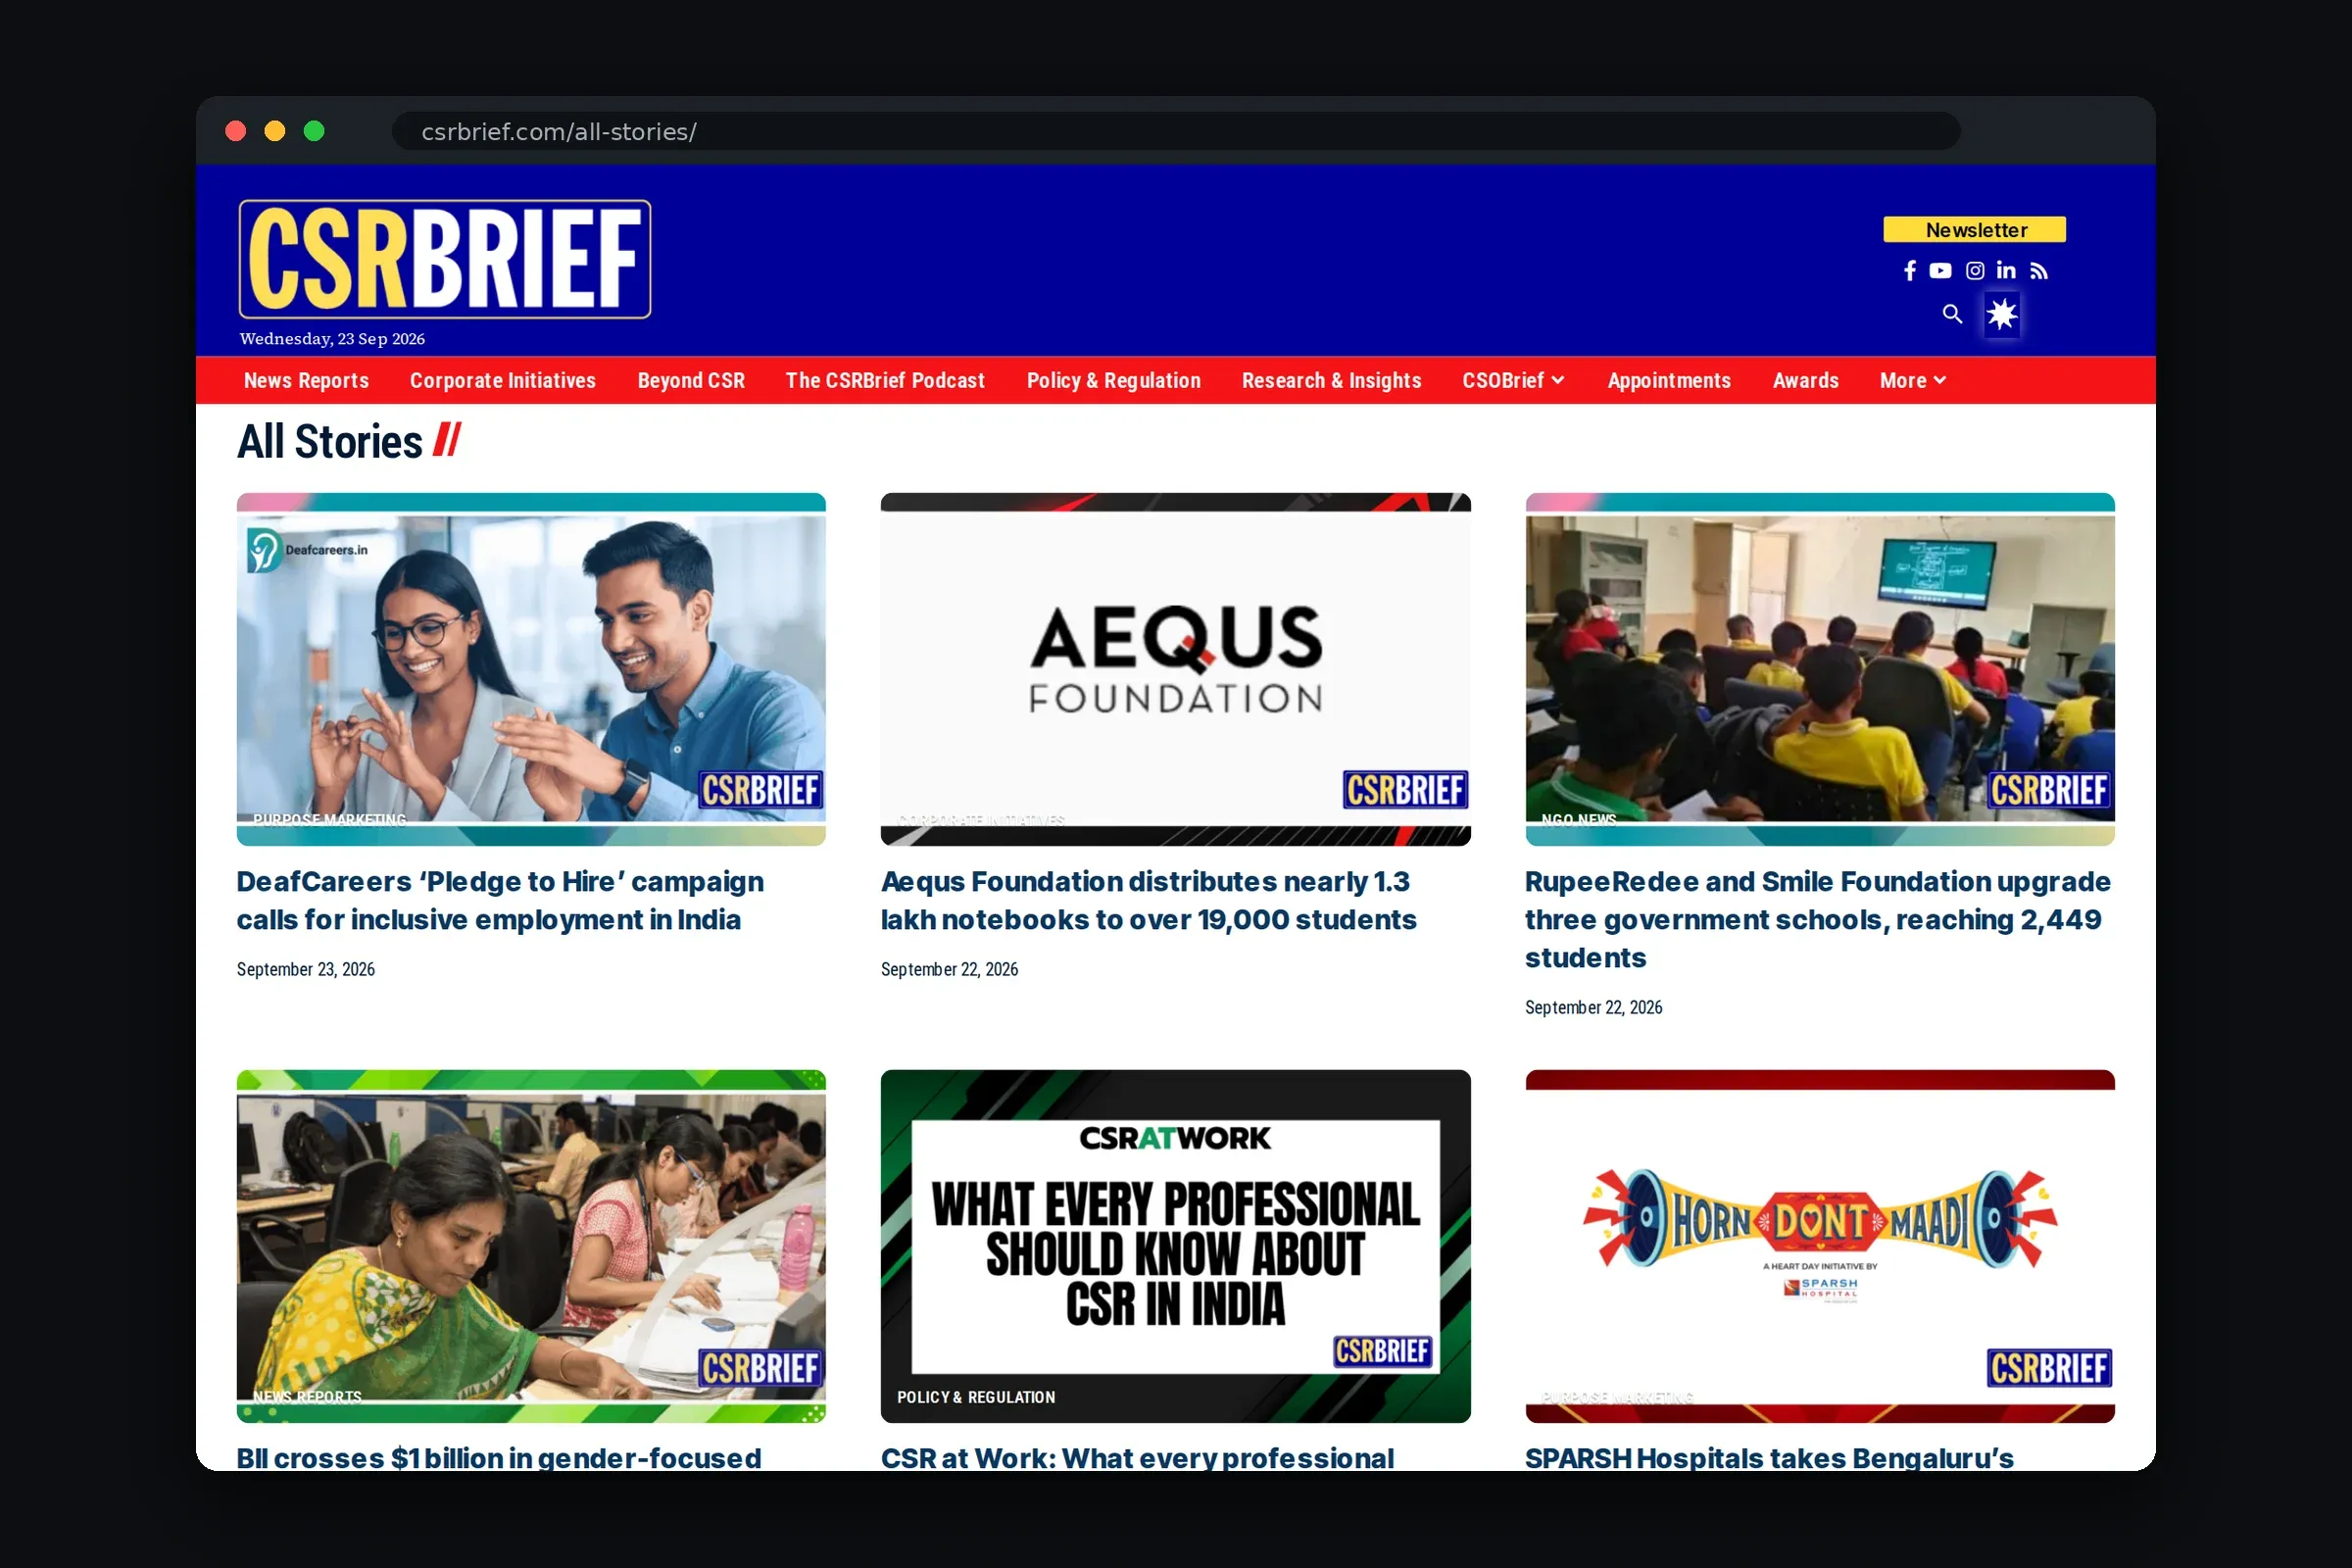
- Voor de archiefpagina All Stories vergeleek ik elk bereikbaar artikel met de sitemap: 150 van 150, nul missend.
Resultaat
Er zijn nog geen gemeten zoekresultaten om te melden. Search Console liet op 9 september 2026 zien dat de site vooral nog niet geïndexeerd was. Wel gemeten op de live site:
- Sitemap van ongeveer 1.100 naar 183 adressen (9 september 2026).
- llms.txt van 110.904 naar 50.241 bytes, zonder tagvermeldingen (9 september 2026).
- Eén meta description en één schemablok per pagina, waar dat er twee of drie waren (27 augustus 2026).
- Auteurs-, tag- en datumarchieven van nul naar tien of meer artikelen per pagina (25 augustus 2026).
Wat de klant zegt
Got yet another project done by Julian, and I’m beginning to sound like a stuck record - he is the best. Only the unfortunate will pass him over. Julian is peerless. Just nobody like him in his space on the freelance professionals universe. Thank you Julian.
Deze reviews zijn geplaatst door geverifieerde klanten via Fiverr. Bekijk ze op mijn Fiverr-profiel. Bekijk alle reviews op Fiverr
Wat er nu volgt
Ik meet in Search Console of de indexering beweegt na het opschonen van de sitemap. Voor de tijdloze reeksen heb ik tabellen, bronnen en interne links voorgesteld, zodat AI-systemen ze makkelijker citeren.
Veelgestelde vragen
Mijn artikelen staan in de sitemap, maar niet in Google. Waar begin ik?
Kijk wat de sitemap nog meer aanbiedt. Bij CSRBrief was ongeveer 85 procent van de adressen een pagina met noindex. Haal die eruit via de SEO-plugin.
Moet ik AI-crawlers apart toestaan in robots.txt?
Niet als er niets geblokkeerd wordt, zoals bij CSRBrief. Een aparte regel voor één crawler kan zelfs averechts werken: die crawler negeert dan de algemene regels.