In het kort
MediaBrief is een Indiaas B2B-nieuwsplatform over media, reclame, marketing en business, met een archief van ruim 71.000 artikelen en vier podcastreeksen. De vraag was om herkend en geciteerd te worden als kennisbron, door professionals en door AI-systemen zoals ChatGPT, Perplexity en Google AI Overviews. Ik maakte van de uitgever één duidelijke identiteit in de gestructureerde data, bouwde drie pagina’s over de redactionele standaard en verving een automatisch llms.txt-bestand door een handgeschreven versie. Sinds eind juli 2026 staat dat live en loopt er een meting in vier AI-systemen.
Feiten in één oogopslag
| Klant | MediaBrief (Responsible Media Private Limited) |
|---|---|
| Sector | B2B-media en uitgeverij, India |
| Periode | Opgeleverd juli 2026, meting loopt door |
| Disciplines | GEO, SEO, webdevelopment, content |
| Techniek | WordPress, All in One SEO Pro, WPCode, WP Rocket, schema.org, llms.txt |
| Status | Live |
Over de klant
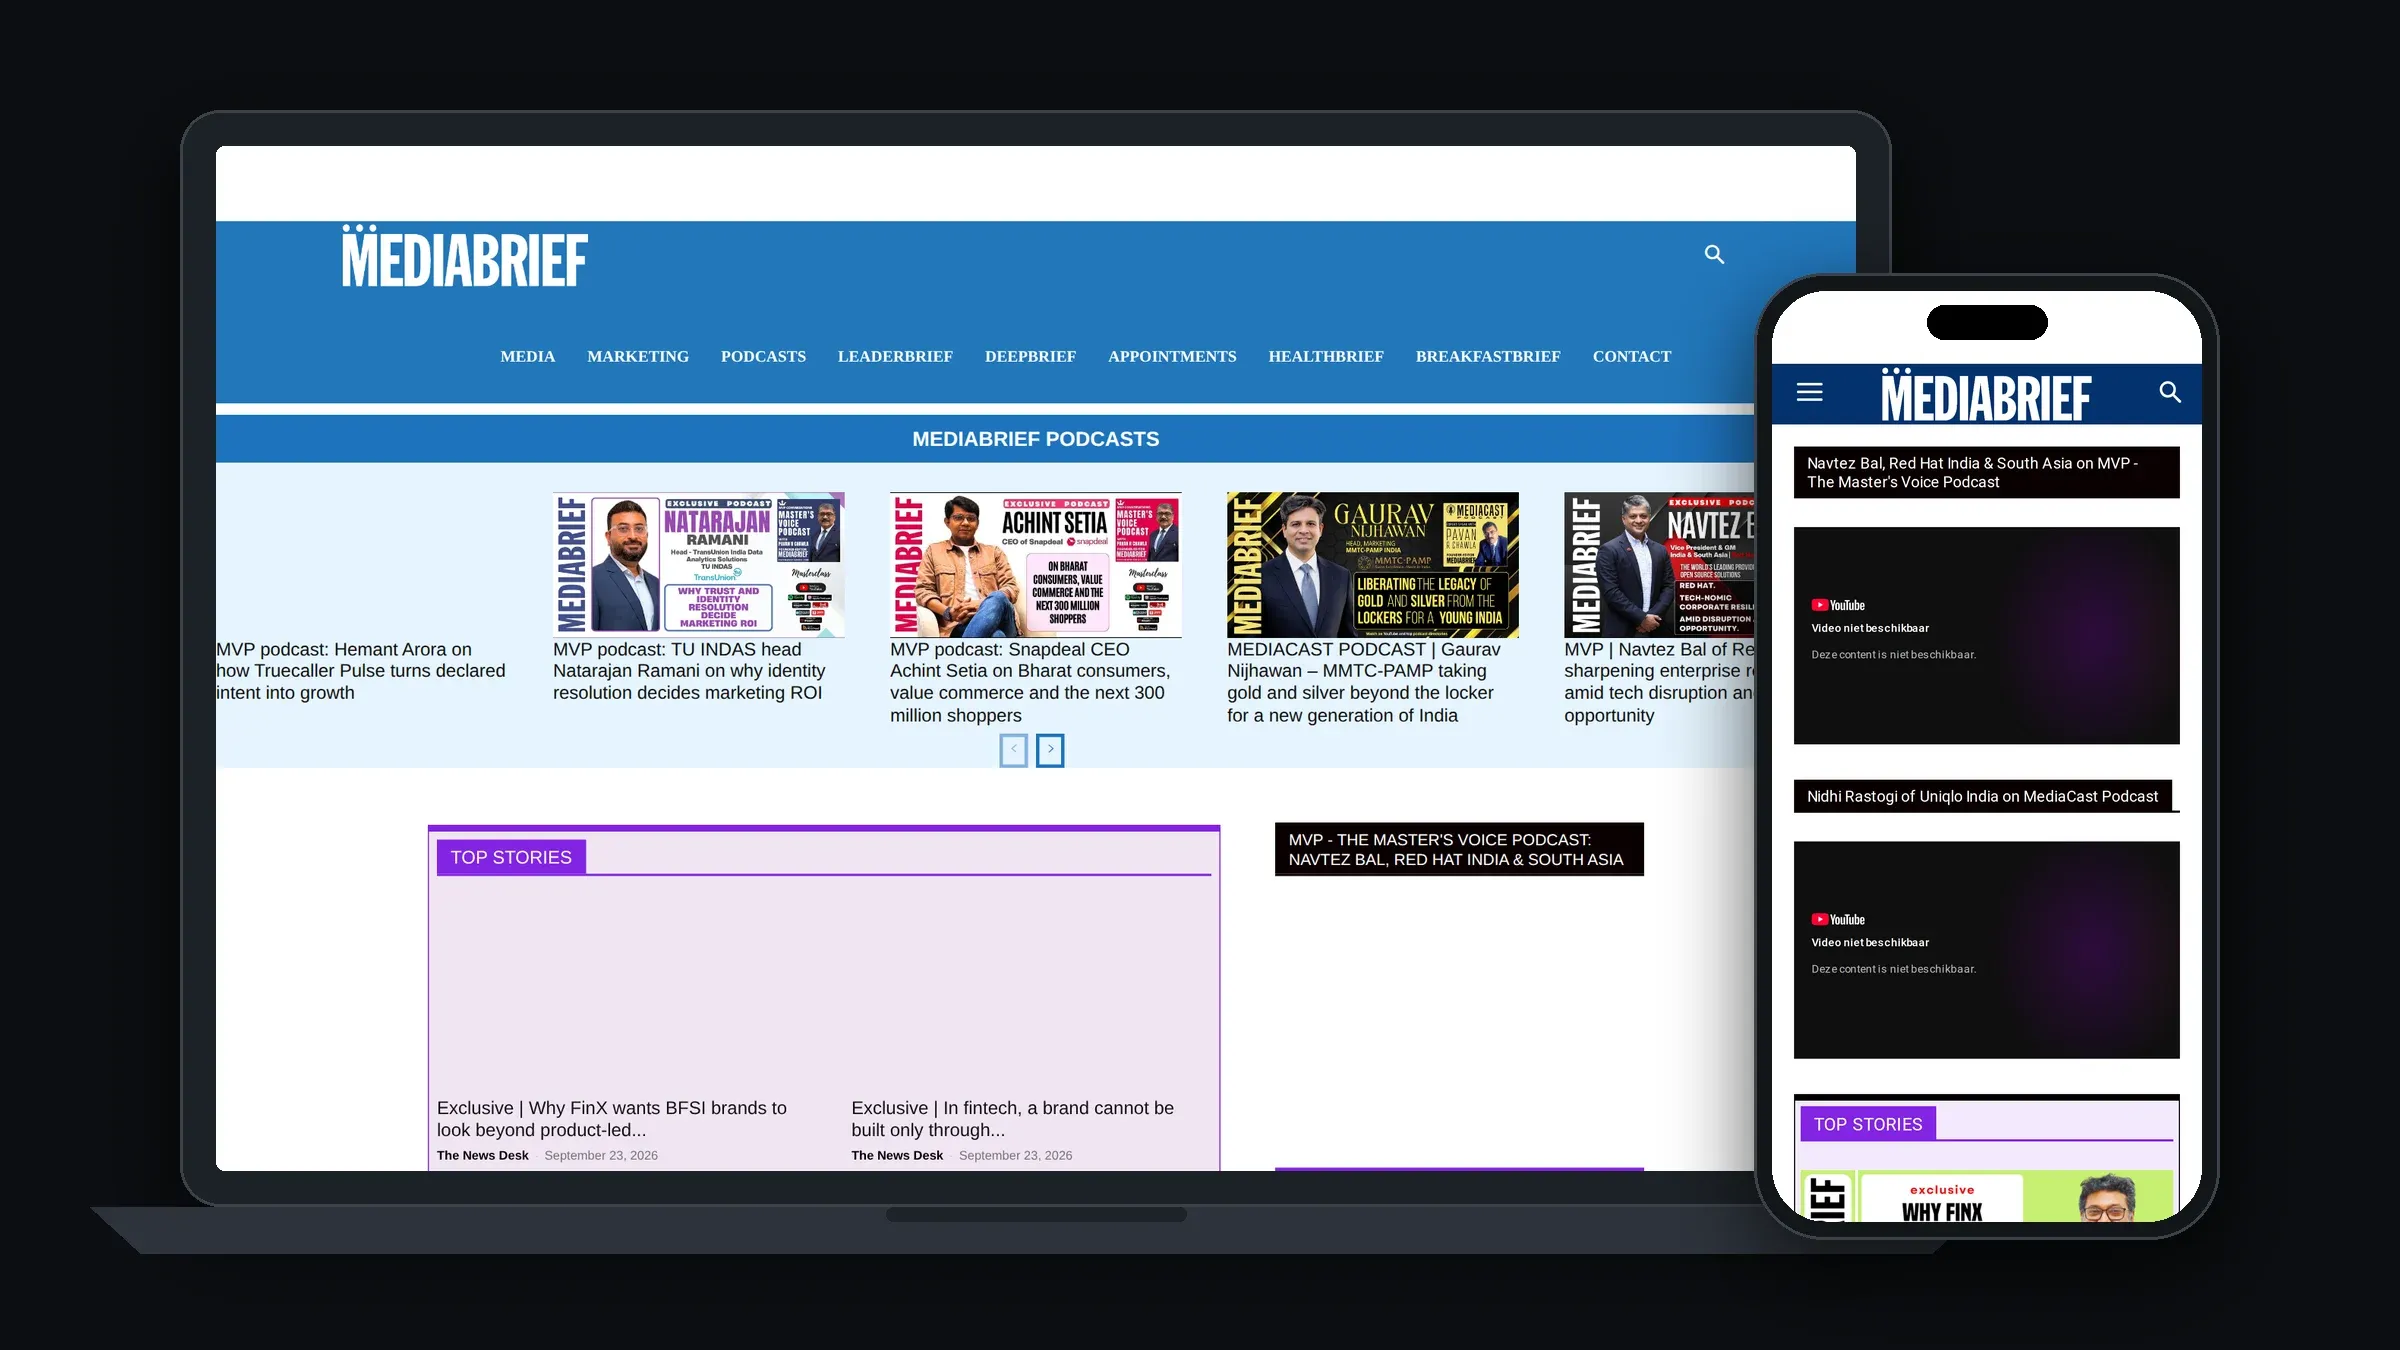
MediaBrief publiceert dagelijks nieuws, interviews, features en podcasts voor professionals in media, marketing en communicatie in India. De site heeft een zeer groot archief, meerdere redactionele merken en vier podcastreeksen. Die omvang maakt het voor een machine lastig om te zien wat bij elkaar hoort.
De vraag
De klant wilde niet alleen beter ranken in Google. Het doel was dat MediaBrief herkend wordt als een echte kennisbron. De hoofdredacteur legde dat zelf vast in een filosofie: kennis vastleggen, verbinden, bewaren en laten groeien. AI-systemen noemen vooral bronnen die ze goed kunnen plaatsen.
De uitgangssituatie
Ik begon met een analyse van de gestructureerde data (code die een machine vertelt wat er op een pagina staat) op een reeks sleutelpagina’s, en met een controle van de merkassets en het llms.txt-bestand (een tekstbestand dat AI-systemen een overzicht van de site geeft). Wat ik vond: de uitgever stond er als algemene organisatie, zonder de velden die een nieuwsaggregator of AI-systeem gebruikt om een redactie te beoordelen. Die velden waren leeg, omdat er geen pagina was om naar te verwijzen. Het logo in de markup was een favicon van 112 bij 112 pixels. De automatisch gemaakte llms.txt was ongeveer 324.000 tekens lang en bestond grotendeels uit tagarchieven. Veel categoriearchieven hadden geen omschrijving.
Wat ik deed
Eén uitgever, één identiteit
Ik maakte van de uitgever één benoemde NewsMediaOrganization (het schematype voor een nieuwsorganisatie). Elke pagina verwijst ernaar met dezelfde identifier, in plaats van de uitgever steeds opnieuw te beschrijven. Ook podcastreeksen en redactionele merken werden entiteiten (herkenbare dingen met een eigen naam). Het logo werd een publisher-logo van 1200 bij 303 pixels. Al het schemawerk staat in dertien snippets in WPCode, bewust niet in het thema. Een thema-update of themawissel wist het dan niet.
Pagina’s die vertrouwen onderbouwen
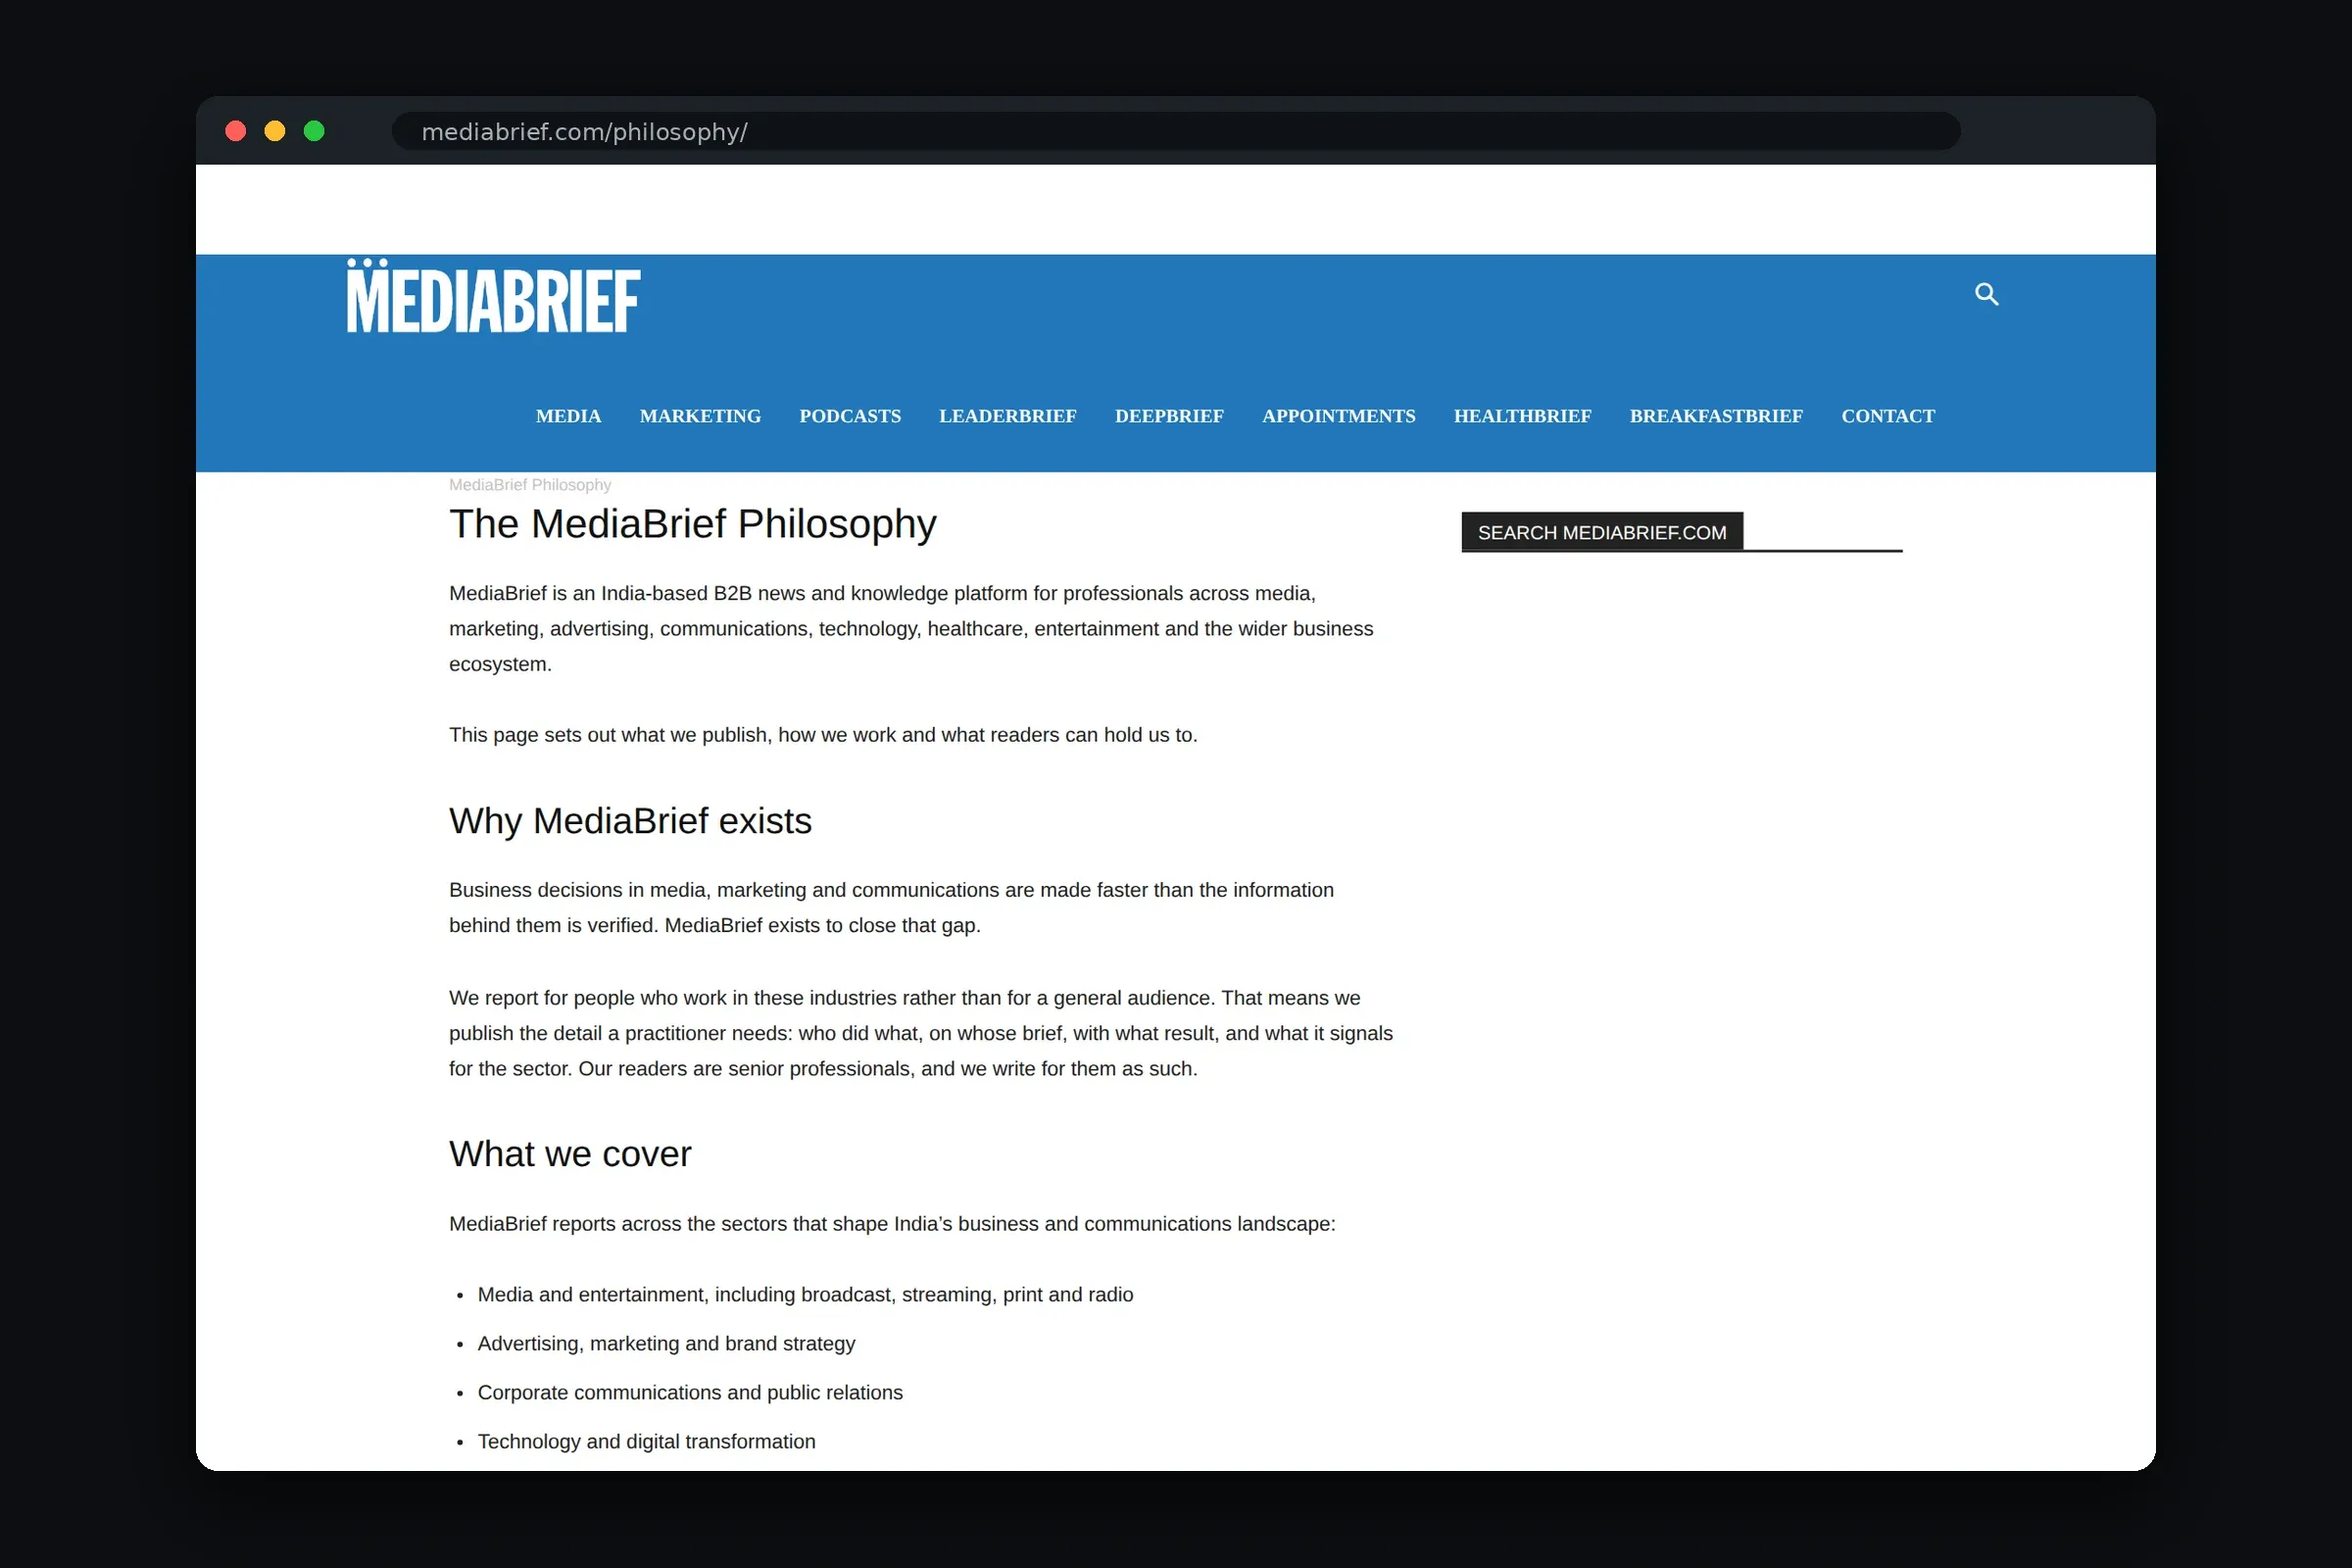
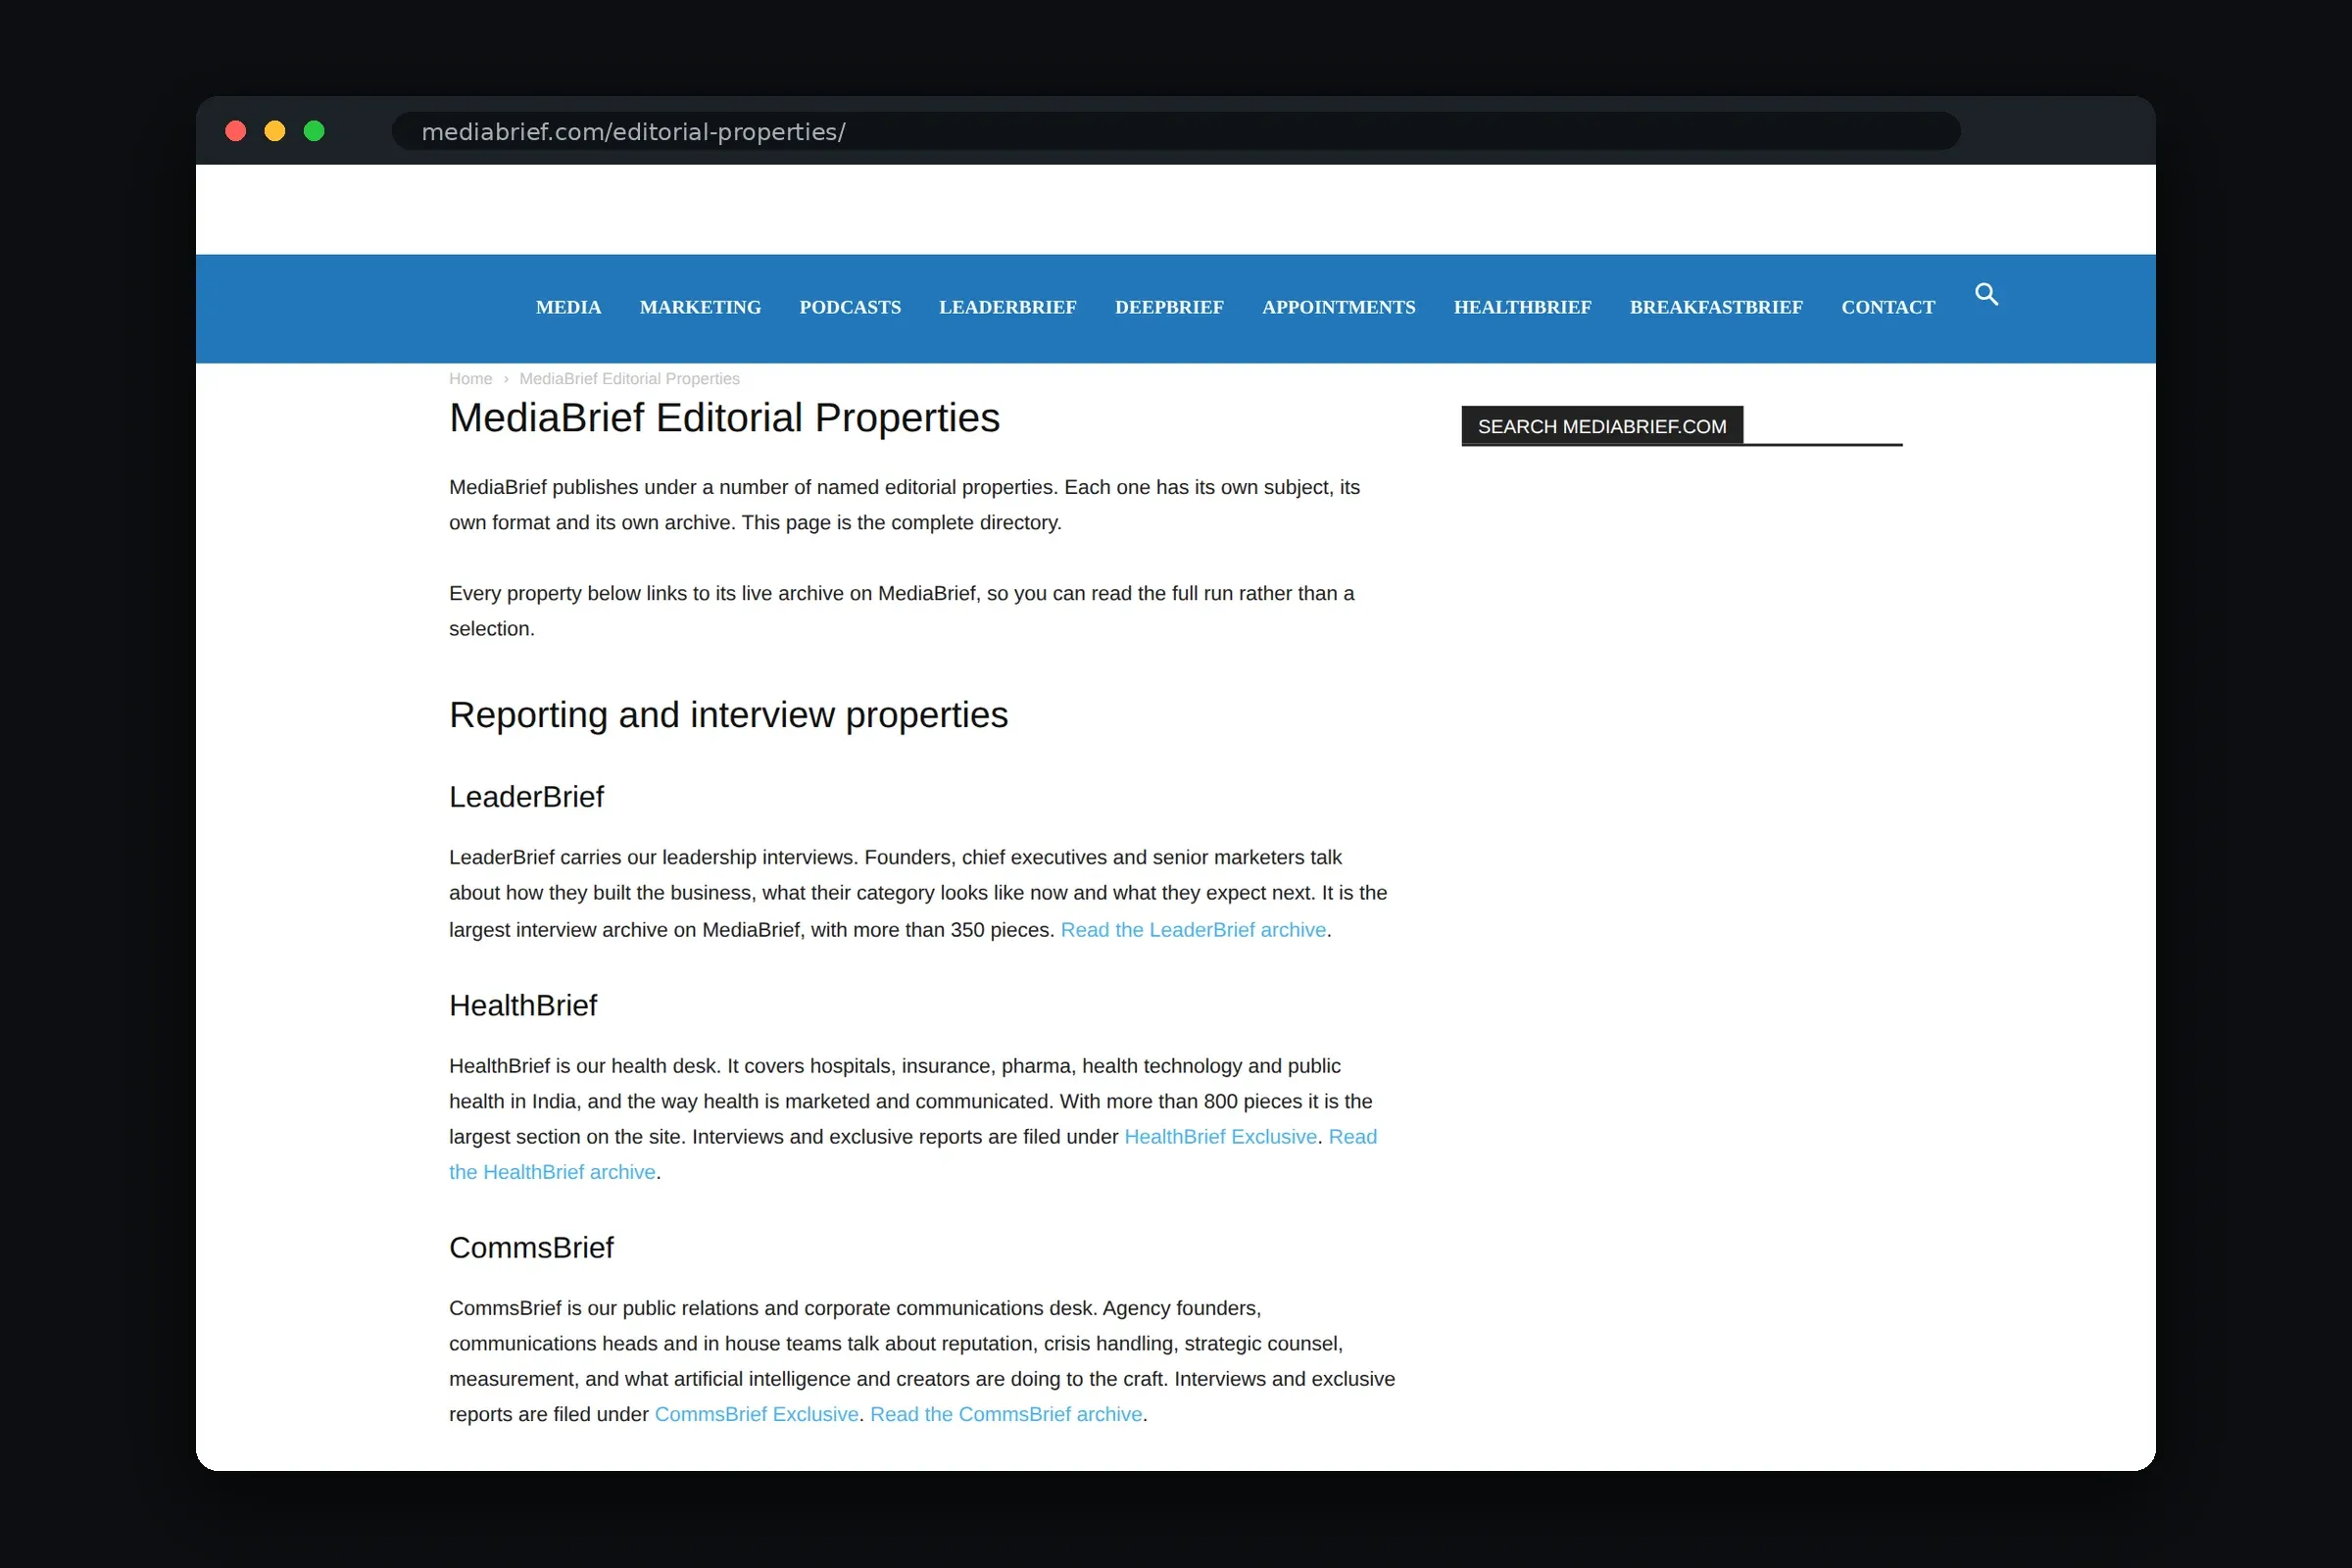
Ik bouwde drie pagina’s: About MediaBrief, Philosophy en Editorial Properties. Philosophy beschrijft hoe verhalen tot stand komen, hoe feiten worden gecontroleerd en hoe correcties gaan. Vier vertrouwensvelden op de uitgever wijzen nu naar die pagina: publishing principles, ethics policy, corrections policy en fact checking policy. Daarnaast kregen ongeveer negentig categoriearchieven een echte omschrijving, en herbouwde ik de navigatie en de footer.
Een llms.txt met de hand
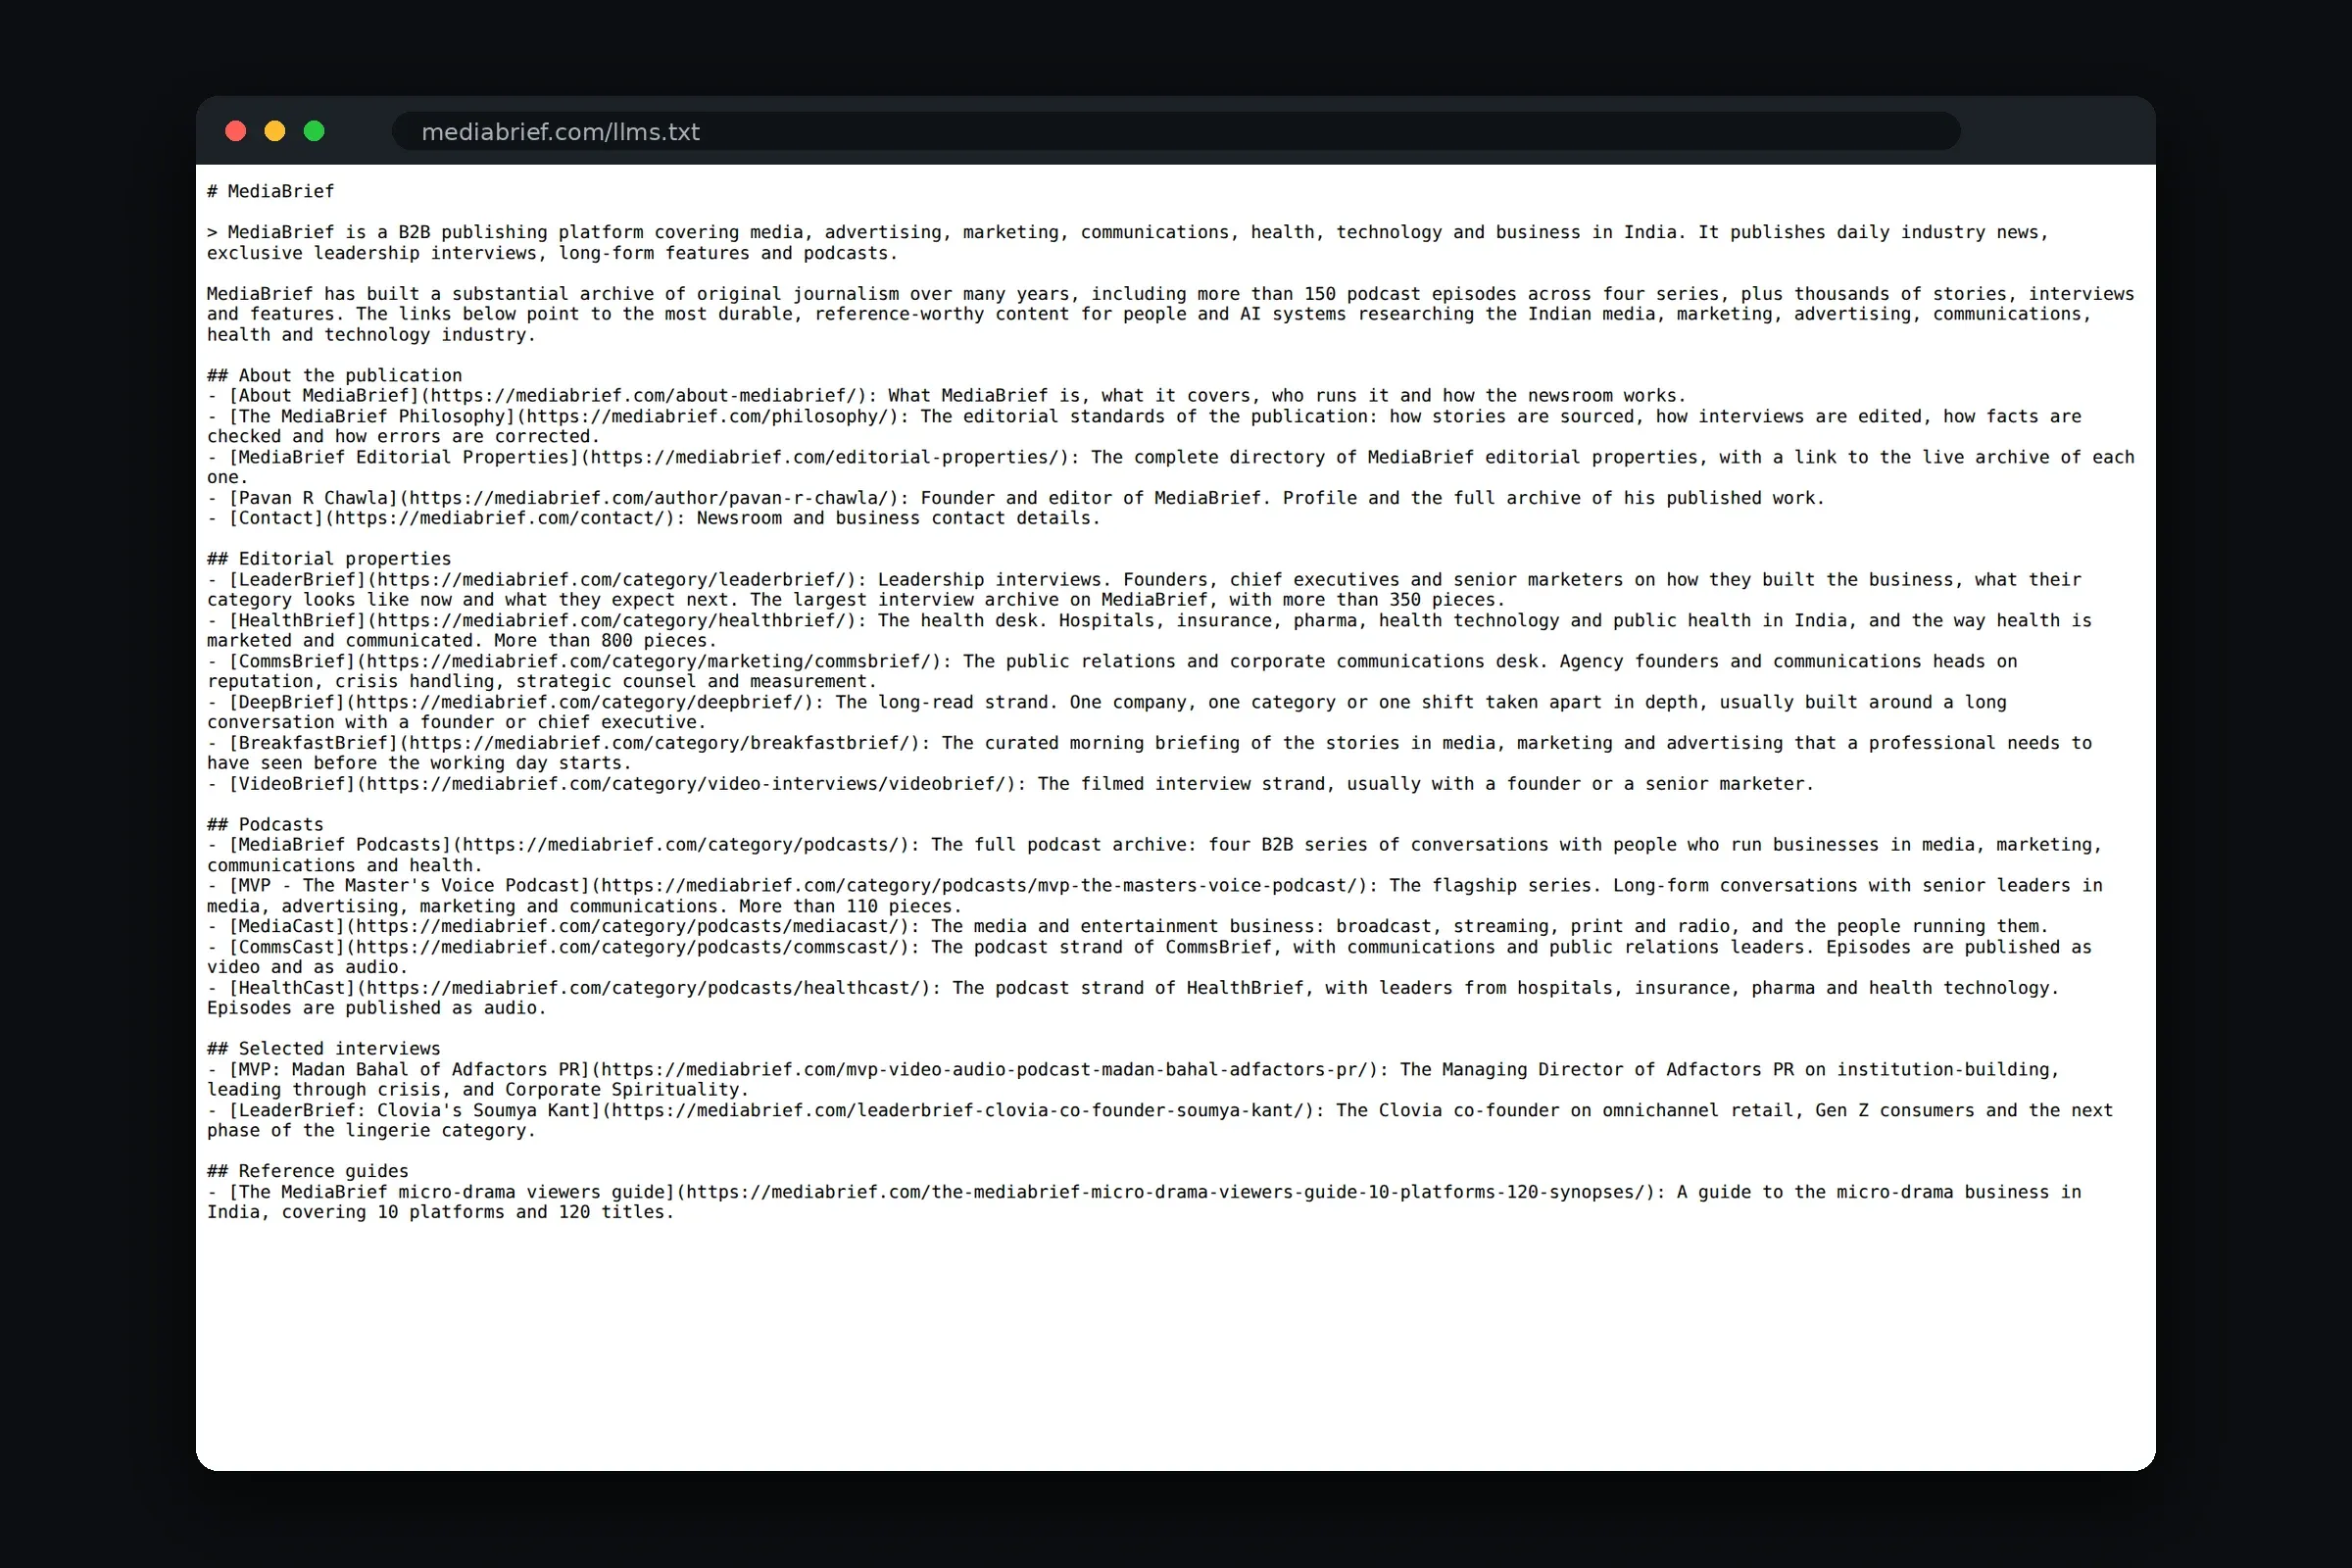
Ik verving de automatische llms.txt door een handgeschreven versie van ongeveer 4.600 tekens met negentien links naar de pagina’s die het meest als naslag dienen. De SEO-plugin schrijft een echt bestand op de server, en zolang dat bestaat komt een snippet er niet aan te pas. Daarom zette ik de automatische generatie uit.
Wat ik bewust niet deed
Ik heb robots.txt (het bestand dat crawlers vertelt wat ze mogen lezen) niet aangepast. Eén fout daarin kan crawlers buitensluiten. Ik heb een advies geschreven en wacht op akkoord van de klant. Ook zet ik nergens een exact aantal artikelen in vaste tekst. Een exact getal klopt een week later niet meer.
Hoe ik het controleerde
- Elke pagina testte ik op de live URL, nadat ik de WP Rocket-cache (de opgeslagen versie van de pagina) voor die URL had geleegd.
- Ik gebruikte validator.schema.org, omdat die elke entiteit toont, ook als Google er geen zoekresultaatweergave voor heeft. Per URL controleerde ik dat er precies één entiteit op paginaniveau en één uitgever stond.
- Elke externe link in de markup, zoals socialprofielen, heb ik zelf geopend voordat hij erin ging.
- Bij de twee FAQ-blokken controleerde ik dat elke vraag woord voor woord zichtbaar op de pagina staat. De Rich Results Test van Google toont FAQ-markup sinds 7 mei 2026 niet meer. Daar niets zien betekent dus niet dat de markup stuk is.
- Een tweede organisatie is niet automatisch een fout. Op een interview staat naast MediaBrief ook de werkgever van de geïnterviewde. Die liet ik bewust staan; samenvoegen zou suggereren dat de geïnterviewde bij MediaBrief werkt.
- Na het uitzetten van de automatische llms.txt controleerde ik dat de live URL de handgeschreven versie toont, en niet het oude bestand.
- Voor de AI-zichtbaarheid maakte ik een nulmeting met 25 tot 30 doelquery’s in ChatGPT, Perplexity, Gemini en Google AI Overviews. De query’s koos ik samen met de klant, op basis van waar de redactie het sterkst is. Elke meting gebeurt met dezelfde formulering, in een verse sessie zonder geschiedenis. Ik noteer of MediaBrief genoemd wordt, of de naam goed valt en welke pagina wordt aangehaald.
Resultaat
Er zijn nog geen gemeten resultaten die ik hier kan tonen (stand september 2026). Wat nu live staat, is alles wat hierboven onder “Wat ik deed” staat. De klant heeft daarnaast een meetbestand waarmee hij zelf volgt hoe AI-systemen MediaBrief noemen.
Wat de klant zegt
Thanks to Julian, this has been, quite simply, the finest Fiverr engagement I have experienced. I wanted to begin with this in the hope that it catches the eye of anyone else looking for potential guide-partners for any of the kind of projects Julian provides. Believe me, he is peerless, and you will thank me after he is done. But first, I want to thank Julian myself, sincerely, for the exceptional standard of work he brought to our project. Across all the specialists I have worked with on Fiverr or anywhere else in the freelancer universe, I have not come across anyone more technically capable, strategically thoughtful, meticulous, transparent or committed. Julian has not merely completed a technical assignment, he has helped us understand, secure and document an important part of the future foundation of one of our brands. Julian's intellectual honesty, patience, care and extraordinary commitment throughout this engagement, has given us far more than a set of optimisations. Julian has helped us understand, secure and preserve a strategically important part of the technical foundation of our brand. Julian's willingness to verify everything against the live site, correct anything that needed correction, explain every decision, preserve reversibility and create a genuinely portable technical archive has been invaluable. Thank you Julian. You stand alone.
Deze reviews zijn geplaatst door geverifieerde klanten via Fiverr. Bekijk ze op mijn Fiverr-profiel. Bekijk alle reviews op Fiverr
Wat er nu volgt
De herhaalmetingen staan op dag 30, 60 en 90 na oplevering. Dag 30 laat vooral zien of de naam goed valt, rond dag 90 wordt zichtbaar hoe vaak MediaBrief geciteerd wordt. Het podcastmodel dat nu op één aflevering staat, ligt klaar om uit te rollen naar de andere afleveringen.
Veelgestelde vragen
Heeft een groot nieuwsarchief wel iets aan GEO?
Ja, juist omdat het archief groot is. Hoe meer pagina’s, hoe belangrijker het is dat een AI-systeem ziet dat ze allemaal van dezelfde uitgever komen. Bij MediaBrief was dat de eerste stap.
Waarom een llms.txt met de hand schrijven als de plugin het automatisch doet?
Het automatische bestand was ongeveer 324.000 tekens en bestond vooral uit tagarchieven. De handgeschreven versie is ongeveer 4.600 tekens en wijst alleen naar pagina’s die als naslag dienen. Elke link daarin heb ik gecontroleerd.